以前说AI优化代码、写报告、编程序,大家不稀奇;现在它开始调教芯片了——不是用嘴说,是真动手改NPU算子。9月7日发布的星火X2.5,干了一件业内头一回的事:用自己训练出来的MoE大模型,反向优化国产昇腾910B芯片的底层算子。这不是实验室Demo,是在无锡万卡智算中心真实跑满负荷的生产环境里干的。2000张摩尔线程S5000、上万张昇腾910B,全链路国产正规实盘配资网站排名,从数据喂进去,到模型训出来,再到它自己帮着调显存分配、压通信延迟、重写低效算子——AI第一次成了算力系统的“内部工程师”。
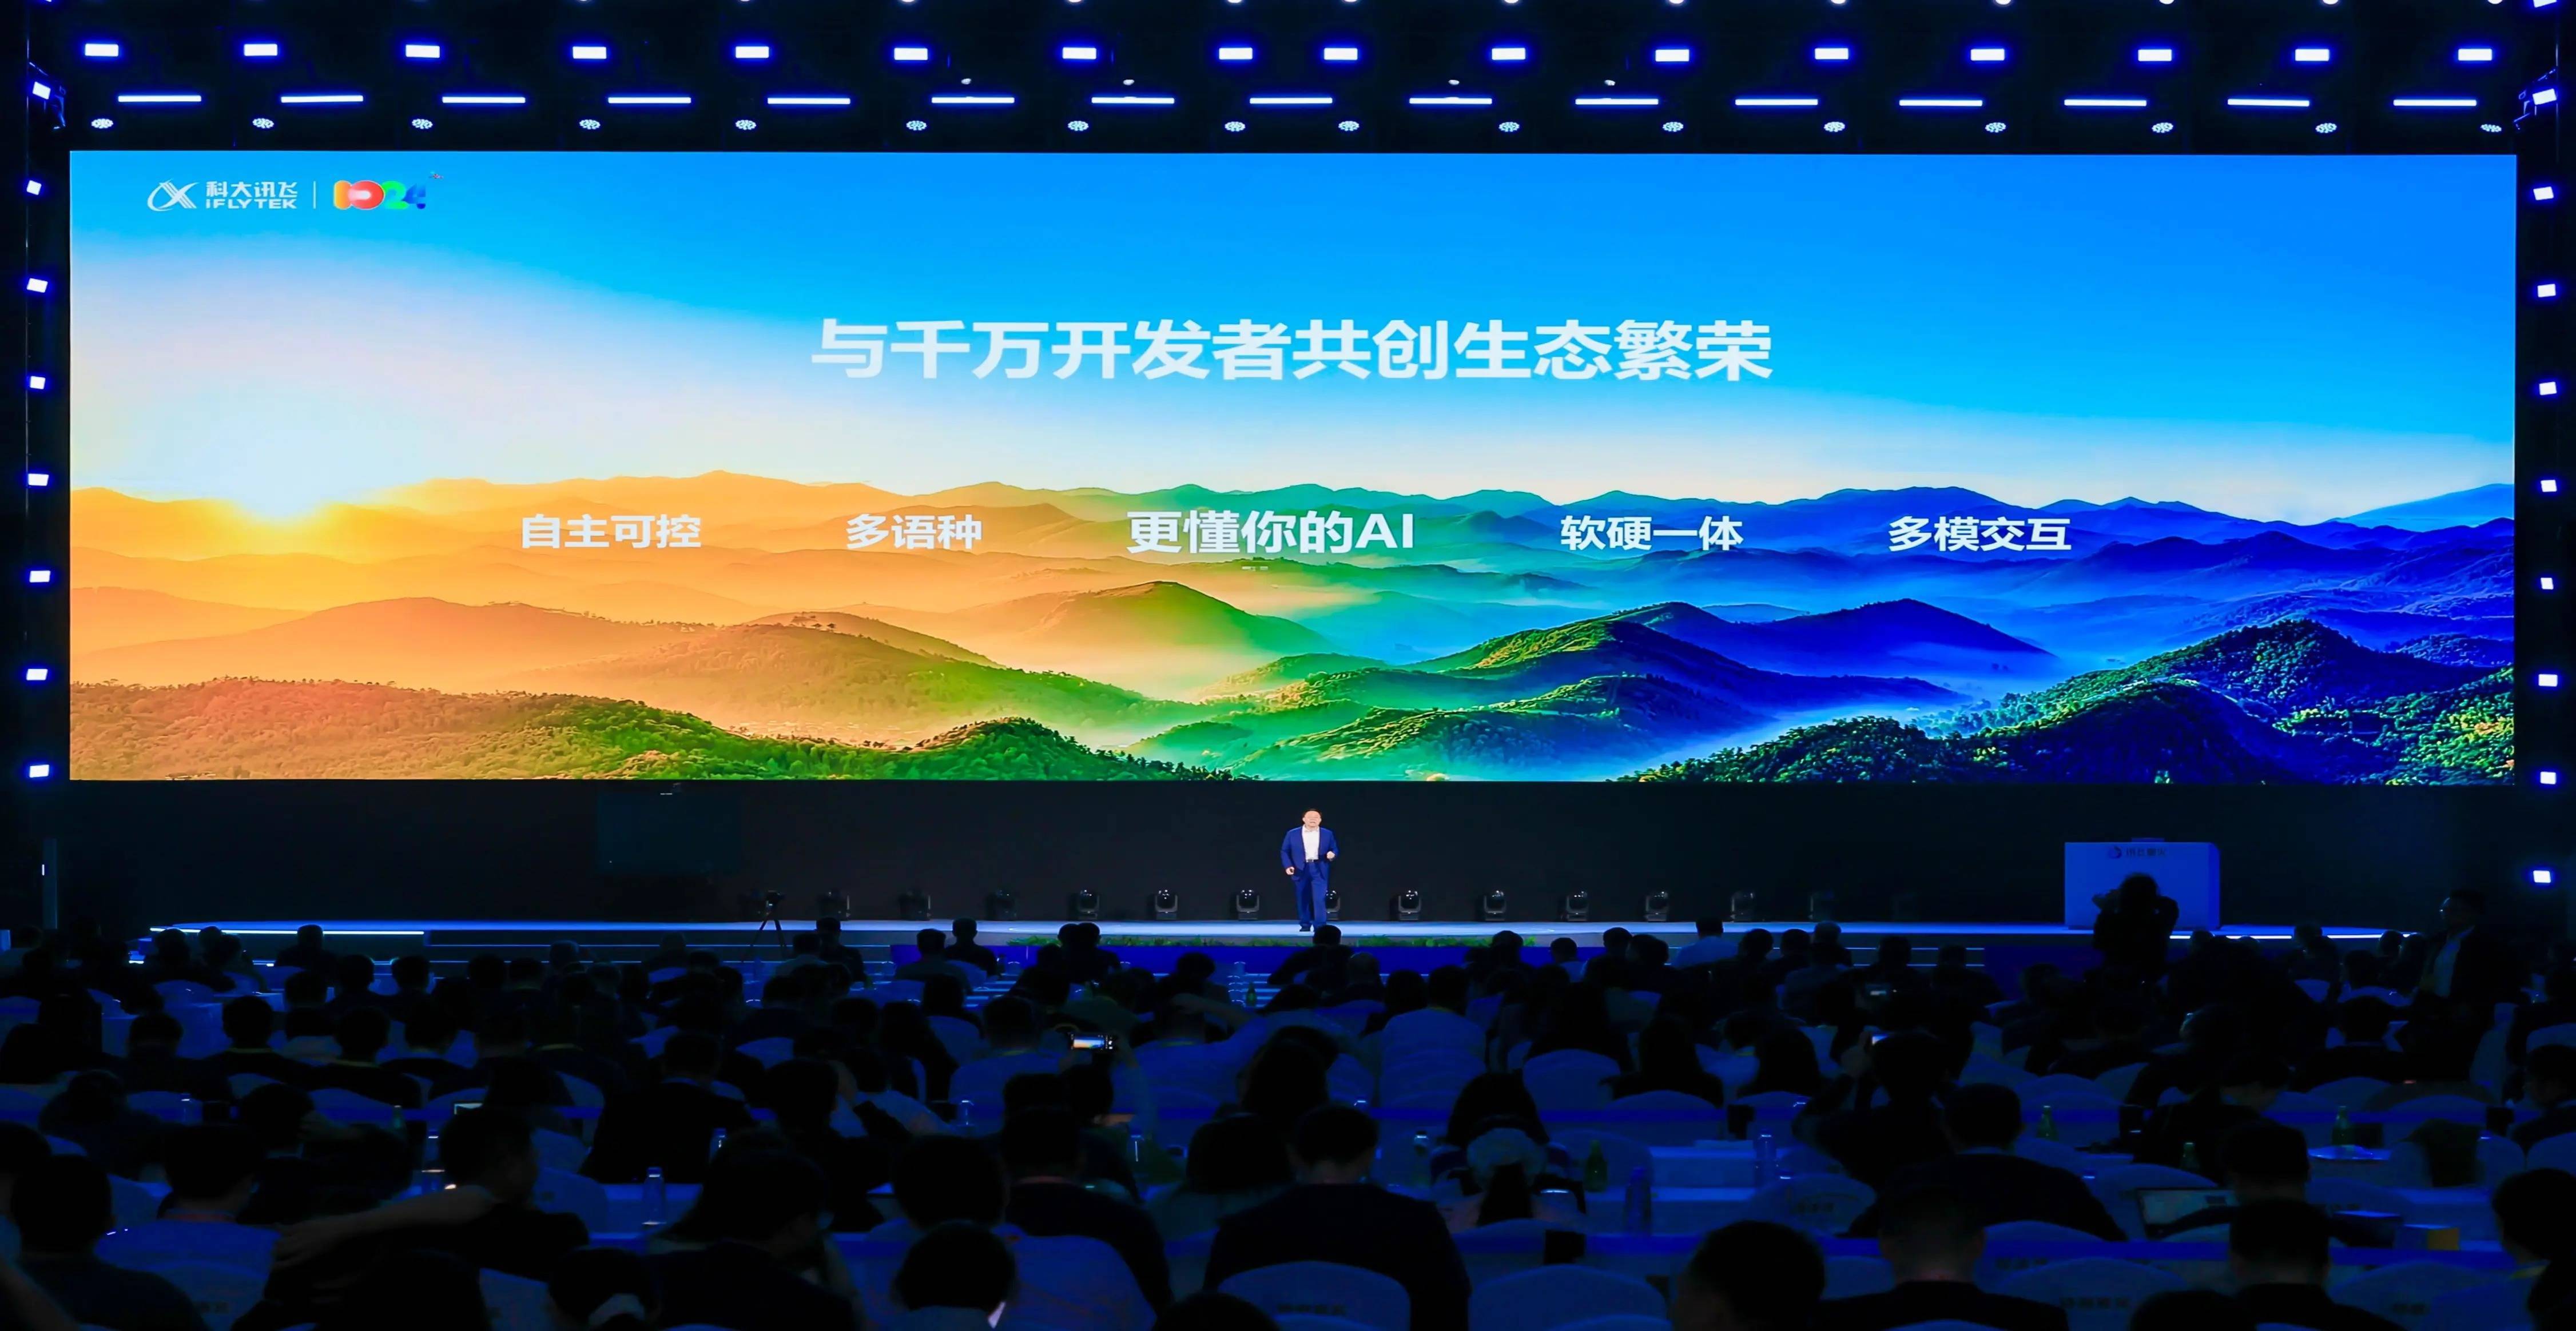
万卡不是堆人头,是建生态。芯片多了,小毛病会放大成大事故:一块卡上一个算子慢1%,万卡并行就可能拖垮整轮迭代;一次跨机通信多等2毫秒,长周期训练下来就是几小时浪费。科大讯飞没硬扛,而是让星火X2.5把训练过程中的性能瓶颈自动识别出来,生成优化建议,再由编译器自动重写——相当于工厂流水线自己发现哪个螺丝拧得不够紧,顺手就调好了。这种“模型训算力、算力养模型”的闭环,比单纯拼卡数、堆参数实在得多。
更关键的是,这条路走通了商业逻辑。2025年讯飞大模型中标金额23.16亿元,超第二到第六名总和;净利润预增40%-70%。没有英伟达卡海,只有两三万张国产卡,却拿下教育、医疗、能源等核心行业210个项目。不是靠PPT讲故事,是靠在国产万卡上真正跑出稳定、低价、能落地的智能体。当别人还在争论“谁家模型分数高”,讯飞已经把AI塞进招投标系统、学习机、医院病历助手里,每天处理18万单项目、帮学生批改作文、替医生抓重点——算力不炫技,只干活。
这背后不是靠运气,而是实打实的“三重咬合”:模型能力、芯片适配、场景闭环。星火X2.5的MoE架构不是为刷榜设计的,它把专家模块按任务动态激活——教学生时调教育专家,写病历时启医疗专家,跑工控指令时切工业专家。每个专家模块都经过昇腾910B的算子级微调,连Tensor Core里的数据搬运路径都重新排布过。中科院计算所今年6月发布的《国产AI芯片协同优化白皮书》里明确提到:传统编译器对MoE稀疏激活的调度支持不足,而讯飞这套“模型驱动算子重写”机制,让910B在混合精度推理下的有效算力利用率从58%提到了83%。
有人问,万卡国产化是不是“被迫选边”?其实早在2022年,讯飞就启动了“燎原计划”,和华为昇腾、寒武纪、壁仞等六家芯片厂商共建联合实验室。不是等芯片做好再适配,而是把训练框架里的算子接口提前半年开放给芯片团队——相当于盖楼前就把水电图纸发给施工方。这种反向定义硬件的能力,让昇腾910B第二代固件升级时,直接集成了讯飞定制的FlashAttention-2加速指令。这不是妥协,是共建。
更实在的是成本账。同样训一个10B参数的教育大模型,用英伟达A100集群要花270万元电费+运维;换成万卡昇腾方案,电费降41%,模型迭代周期从14天缩到5.2天。教育客户最关心的不是FLOPS,而是“今天推的新题型,明天能不能进学习机”。讯飞把模型更新包压缩到83MB,通过边缘端增量热更新,30万台学习机一夜同步。这已经不是技术炫技,是把AI变成了像水电一样的基础设施。
现在无锡智算中心每天有73个行业模型在并行训练正规实盘配资网站排名,其中41个由客户自己的工程师用讯飞低代码平台调参上线。没有GPU,不等于没有智能——只是换了一种更扎实、更接地、更敢在真实世界里磕碰的活法。
文章为作者独立观点,不代表河南配资网-线上配资平台-配资实盘平台观点